О проекте
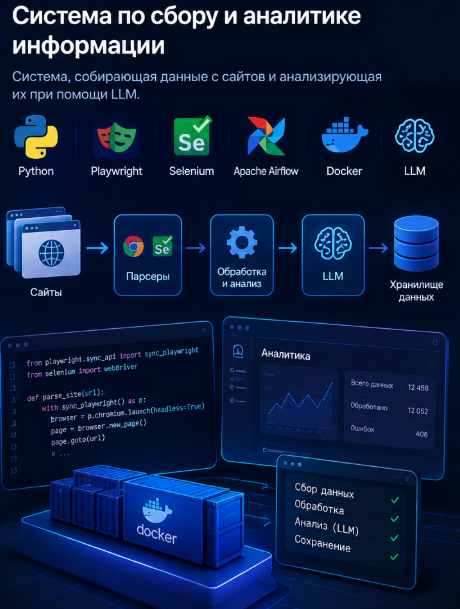
Система предназначена для автоматизированного сбора информации с различных сайтов и её последующего анализа с использованием больших языковых моделей. Данные собираются и обрабатываются в автоматическом режиме, после чего сохраняются для дальнейшего анализа и использования. В данном проекте я занимался разработкой Python-парсеров с использованием Playwright и Selenium для автоматизированного сбора информации с сайтов. Использование обеих библиотек было обусловлено необходимостью обхода JavaScript-защит, препятствующих автоматизированному доступу к веб-ресурсам. После создания и тестирования парсеров я занимался оптимизацией их работы и использования ресурсов, в том числе переносом парсеров в Docker-контейнеры. Особое внимание уделялось запуску парсеров в headless-режиме, без использования графического интерфейса. Следующим этапом стала интеграция отдельных компонентов проекта в единую последовательность задач с использованием Apache Airflow. Задачи были организованы таким образом, чтобы компоненты системы оставались слабо связанными между собой, что позволяло независимо запускать и контролировать отдельные этапы обработки данных. Итогом проекта стал контейнеризированный конвейер для автоматизированного сбора, обработки и анализа информации.